ИИ неправильно описывает бренды в 50% случаев
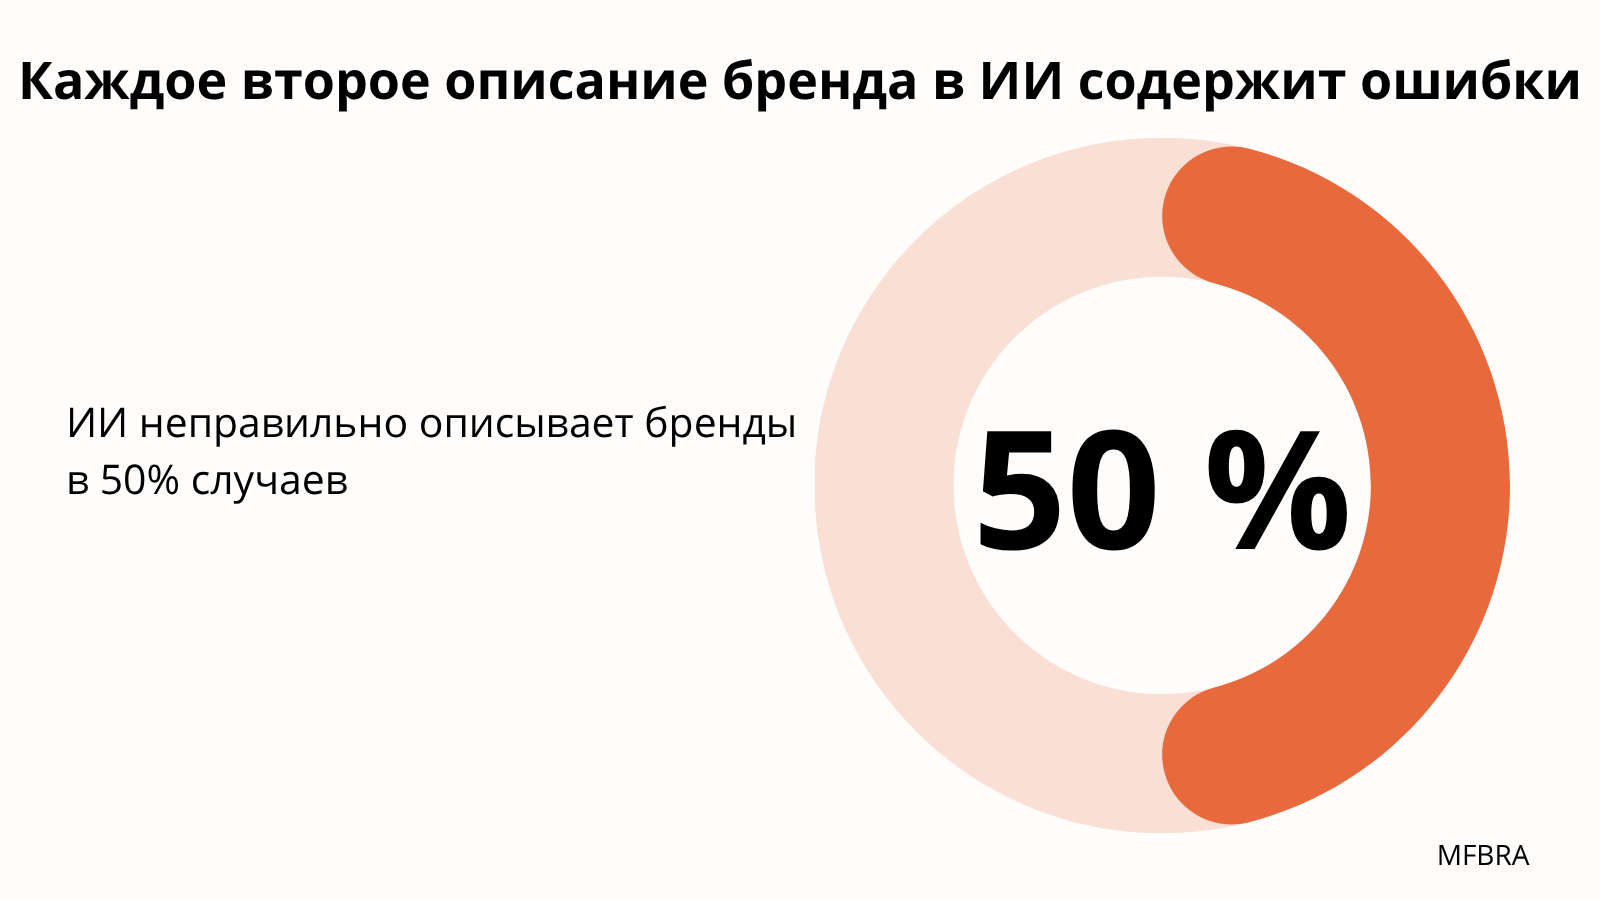
ИИ уверенно и бегло описывает бренды, которые плохо знает. Аудит MFBRA, опубликованный в июне 2026 года, измерил масштаб проблемы: около 50% описаний брендов содержат фактические ошибки. Исследование охватило более 50 брендов электронной коммерции среднего рынка в 11 странах, всего около 200 аудитов. Стоимость воспроизведения одного аудита - около двух центов.
Методика аудита построена на пяти факторах: бренд, тестовый запрос, категория, тип сущности и модель ИИ. Каждый ответ оценивается по доле голоса, пяти показателям видимости (присутствие, ясность, охват, авторитет, предпочтение), тональности и рангу цитирования. Такая конструкция позволяет отделить видимость от точности - и это ключевое различие.
Три находки, которые меняют картину
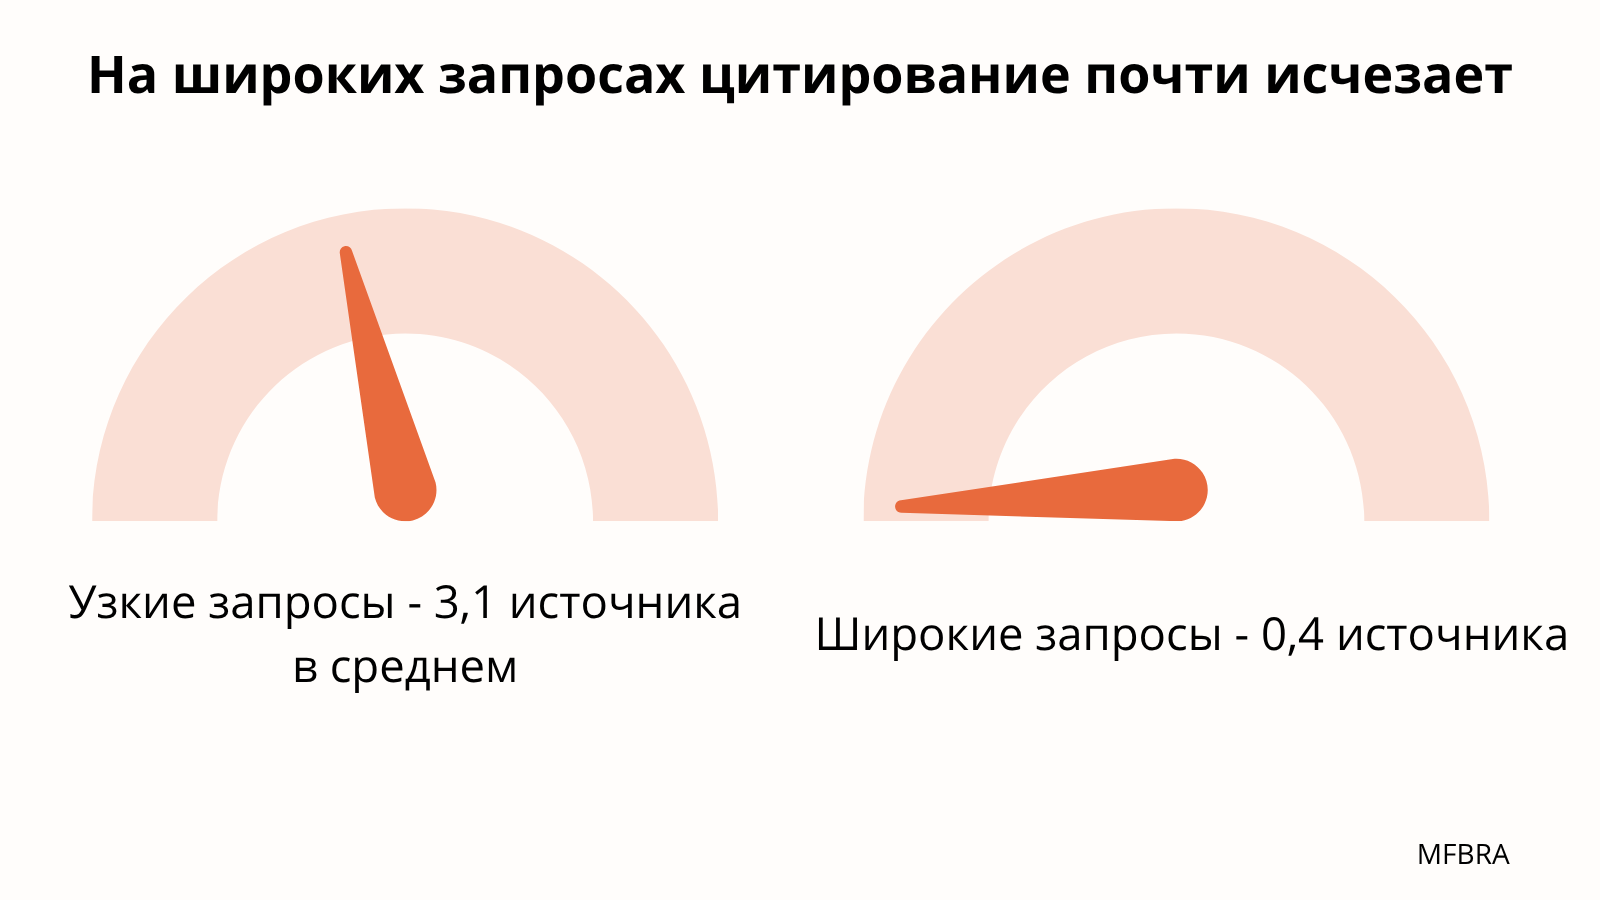
Первая: количество цитат обваливается с ростом широты запроса. На узких запросах средний показатель цитирования составляет 3,1 источника. На широких - 0,4. Разрыв почти восьмикратный. Это означает, что бренд, который хорошо представлен в ответах на конкретные вопросы, почти исчезает, когда покупатель формулирует запрос общими словами.
Вторая: при 100% доле голоса на trust-запросах происходит падение тональности на 10-15 пунктов. Парадокс в том, что бренд присутствует в каждом ответе, но само описание становится менее позитивным. Формально видимость максимальная, фактически - качество присутствия ухудшается.
Третья: около 50% описаний содержат фактические ошибки. Не спорные оценки, не разные трактовки, а именно неверные факты. Это самая тревожная цифра исследования, потому что она означает: ИИ не просто не называет бренд, он называет его неправильно.
Как это выглядит на практике
MIT Sloan Management Review в октябре 2026 года описал реальный кейс инвестиционной платформы из Новой Зеландии. К середине 2025 года ChatGPT генерировал около 700 реферальных сессий в месяц, посетители из этого канала имели более низкий показатель отказов и просматривали больше страниц, чем из других источников. По классическим метрикам поисковой оптимизации сайт работал хорошо.
Но команда не могла ответить на главный вопрос: что именно ИИ говорит клиентам о компании. Когда они начали систематически опрашивать ChatGPT теми же вопросами, которые задают реальные клиенты - о комиссиях, выборе фондов, сравнении с конкурентами, - ответы оказались уверенными, беглыми и часто неверными.
Один широко повторяемый тезис утверждал, что платформа предлагает пять фондов вместо фактических семи. Структуры комиссий были искажены. Защитный инвестиционный механизм был описан как ограничительный. Функции одного продукта смешались с другим продуктом. Для финансовой компании это означало, что потенциальные клиенты получали неверную информацию именно в тот момент, когда изучали варианты пенсионных накоплений.
Этот кейс показывает главное: проблема не в отсутствии видимости, а в её качестве. Бренд может быть заметным и при этом систематически описываться неправильно.
Нестабильность тональности
Исследование Ranqo на 102 брендах и 102 025 ответах добавляет контекст о том, насколько нестабильна тональность. Упоминание бренда в ответе ИИ - величина почти бинарная. Тональность же меняется в 6,7 раза чаще, чем сам факт упоминания. Иными словами, вопрос «называют ли ИИ этот бренд» имеет относительно устойчивый ответ, а вопрос «как именно его описывают» - нет.
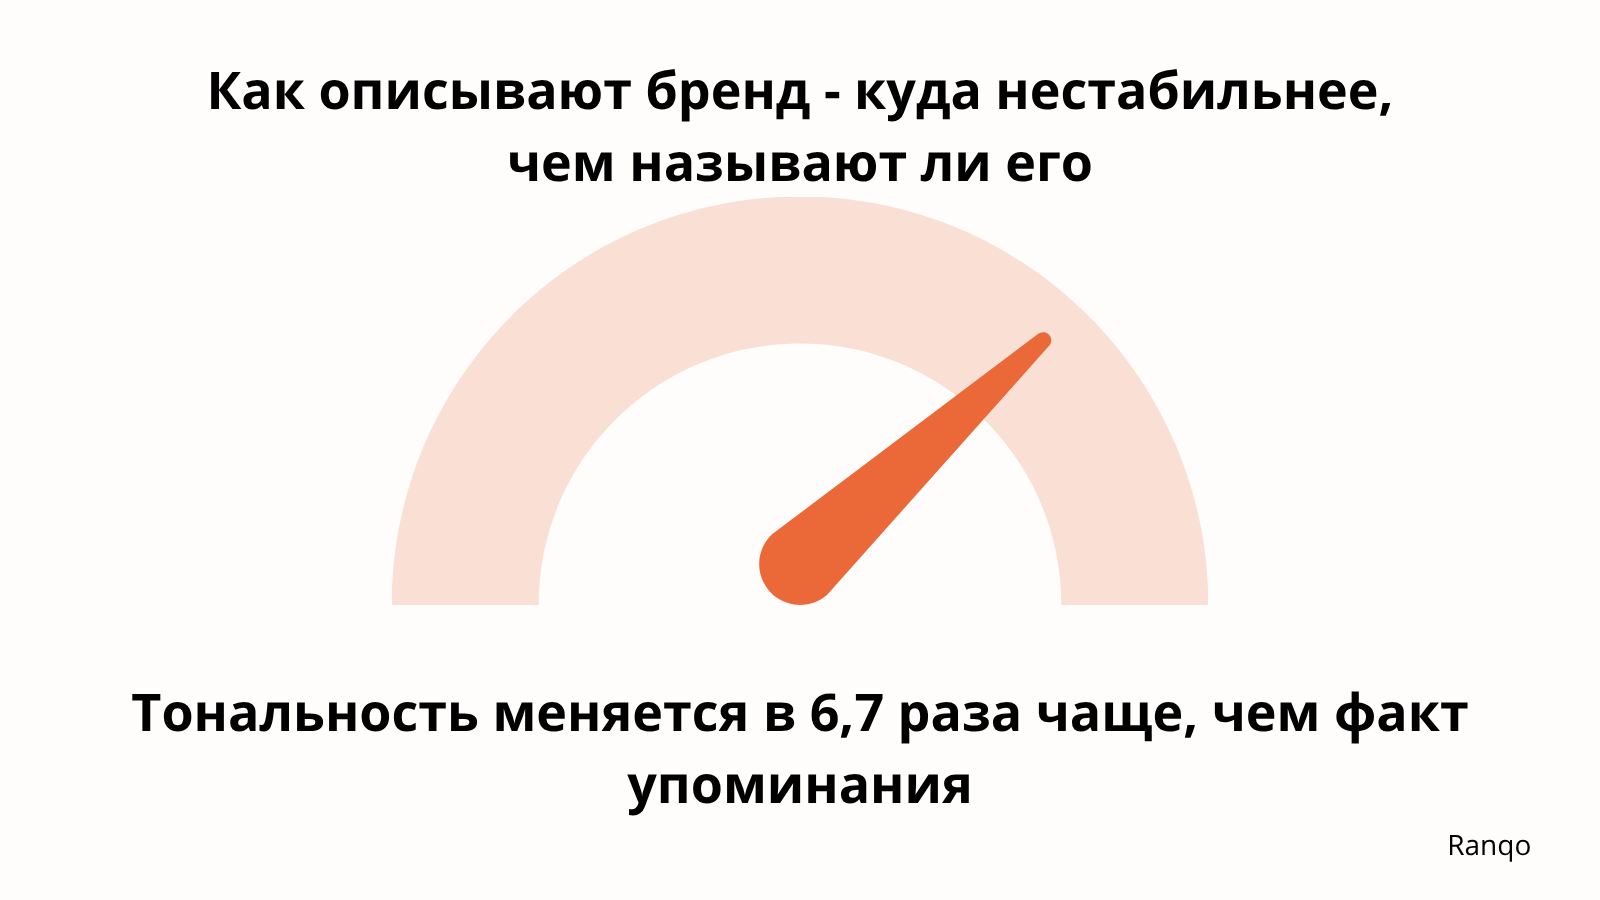
Это объясняет, почему аудит MFBRA фиксирует падение тональности на trust-запросах при максимальной доле голоса. Бренд присутствует везде, но формулировки вокруг него гуляют. Для компаний это означает, что разовая проверка ответов ИИ бесполезна - нужен регулярный мониторинг.
Что это означает для бизнеса
Первое. Видимость и точность - разные метрики. Бренд может иметь 100% долю голоса и при этом получать искажённые описания. Отслеживать нужно обе характеристики отдельно, иначе программа видимости будет отчитываться об успехе, пока клиенты читают неверные факты.
Второе. Широкие запросы - зона риска. Падение цитирования с 3,1 до 0,4 означает, что бренд, сильный в узких вопросах, теряется в общих. Если покупатель формулирует запрос широко, бренд может не попасть в ответ вообще. Это требует контента, который покрывает не только конкретные продукты, но и категорию в целом.
Третье. Trust-запросы опаснее, чем кажется. Именно на них при максимальной видимости происходит падение тональности на 10-15 пунктов. Вопросы о надёжности, безопасности, репутации - те, где ошибка ИИ стоит дороже всего. Для финансовых, медицинских и юридических брендов это критическая зона.
Четвёртое. Аудит доступен по цене. Около двух центов за аудит означает, что систематическая проверка ответов ИИ перестала быть роскошью крупных корпораций. Бренд среднего размера может позволить себе регулярный мониторинг по всем моделям и запросам.
Пятое. Фактические ошибки нужно исправлять на уровне источников. ИИ ошибается не случайно - он синтезирует то, что находит. Если 50% описаний содержат неверные факты, значит, в источниках, на которые опирается модель, есть противоречия или пробелы. Работа с собственными страницами, отзывами, справочными платформами и отраслевыми публикациями - это работа над точностью, а не только над видимостью.
Вывод
50% описаний содержат фактические ошибки. Цитирование падает с 3,1 до 0,4 по мере расширения запроса. Тональность на trust-запросах снижается на 10-15 пунктов при 100% доле голоса. Тональность в 6,7 раза нестабильнее, чем факт упоминания. ИИ не просто не называет бренды - он называет их неправильно, и делает это уверенно.
Бренды, которые измеряют точность наряду с видимостью и работают с источниками, из которых ИИ черпает факты, получают преимущество. Те, кто следит только за долей голоса, рискуют обнаружить, что максимальная видимость сочетается с систематическим искажением реальности.